 前端知识库
AI 前端工程的四层闭环:Prompt、Context、Harness 与 Loop
用四层模型拆解 AI 应用从意图、信息到受控执行和反馈迭代的工程责任。
AI 前端工程的四层闭环:Prompt、Context、Harness 与 Loop
四层分别回答“要做什么、应该看到什么、允许怎么做、完成后怎么办”,适合用来拆解 Agent 的可靠性问题。
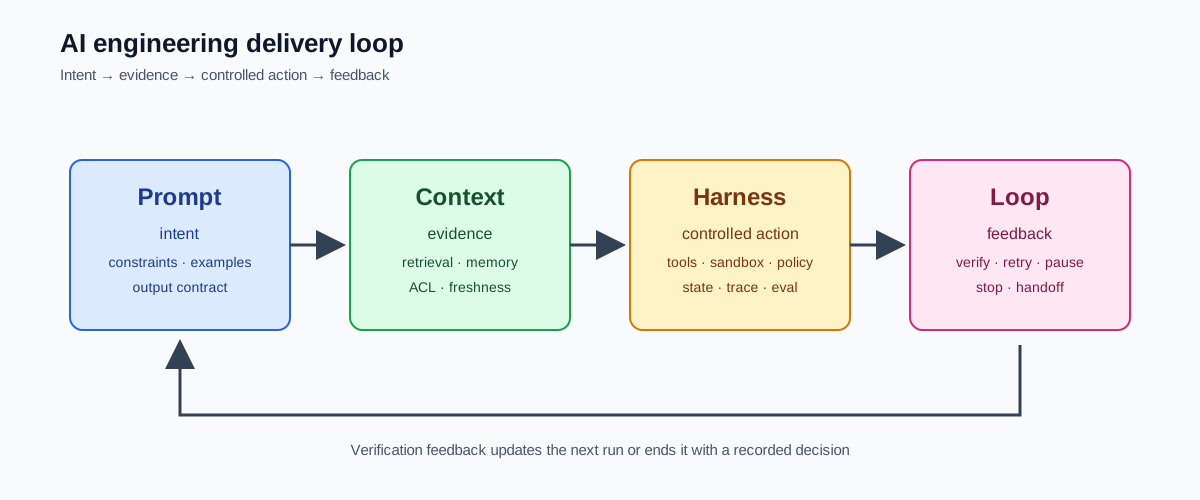
1. 四层的责任边界
| 层 | 核心问题 | 主要对象 | 典型失败 |
|---|---|---|---|
| Prompt | 任务要表达成什么约束 | 指令、示例、输出协议、验收标准 | 目标含糊、格式不可解析 |
| Context | 模型应该看到哪些证据 | 检索、记忆、工具结果、版本和权限 | 噪声、过期、冲突或越权信息 |
| Harness | 模型在什么环境中行动 | 沙箱、工具契约、状态、权限、观测、评测和治理 | 误操作、死循环、无法恢复 |
| Loop | 一步完成后如何收敛 | 触发、检查、重试、升级、终止和持久化 | 无条件重试、状态漂移、没有停止条件 |
四层是叠加关系。Prompt 定义目标,Context 提供证据,Harness 限制动作,Loop 根据反馈决定继续或停止。只增强其中一层,不能自动修复其他层的缺陷。
2. Prompt 与 Context:先定义任务,再组织证据
生产 Prompt 应把身份、目标、输入、约束、输出协议、不确定性处理和验收条件分开。少量示例适合表达难以形式化的业务标准,但不能替代权限和运行时校验。
Context 是一次执行的有限预算。可按优先级组装系统规则、当前目标、可信证据、近期状态和工具结果;对长历史做裁剪或摘要,对关键结论保留原文定位,并在召回前后执行租户和 ACL 过滤。上下文变长不等于信息变好,冲突、过期和重复内容都可能降低判断质量。
仓库知识还需要自己的生命周期:索引条目应记录文件路径、提交版本、符号或文档区段和权限;代码变更、删除或权限调整时触发增量失效或重建;召回时校验版本仍然有效,避免把旧接口、已删除配置或过期规范注入模型。把知识写入索引只是生产动作,维护和撤销同样属于工程契约。
3. Harness:用 ETCLOVG 管理执行风险
Harness 可以拆成七个相互协作的能力面:
| 能力面 | 必须回答的问题 |
|---|---|
| Execution | 在什么沙箱、文件系统和网络边界中运行? |
| Tool | 工具的输入输出契约、超时、幂等和失败码是什么? |
| Context | 哪些上下文与记忆可见,如何过期和撤销? |
| Lifecycle | 任务状态如何流转,重试、取消和恢复如何定义? |
| Observability | 如何用 runId/traceId 追踪步骤、成本和延迟? |
| Verification | 完成条件、回归集和人工验收如何判定? |
| Governance | 哪些动作需要审批,如何审计、限权和紧急撤销? |
七个面不是互相独立的清单。更换执行沙箱可能改变评测结果,增加工具描述会挤占上下文,加入观测也可能影响延迟。因此变更任何一层,都要用完整任务集做回归。
工具执行应由应用层做最终决定,模型只能提出候选动作:
模型提出动作
  -> schema/权限/资源归属检查
  -> 幂等键、审批、限额与超时检查
  -> 沙箱执行
  -> 脱敏结果与轨迹记录
  -> 成功、可重试失败或人工接管
浏览器自动化也应遵守同一契约:为每个任务创建隔离的浏览器上下文,登录态由凭据代理按租户和任务范围注入,动作只允许访问白名单页面和定位器;截图、DOM、网络摘要回传前要脱敏。页面结构变化、登录过期和动作超时应进入可恢复的失败状态,不能让模型自行猜测新的高权限操作。
4. Loop:把一次调用变成可收敛的系统
一个 Loop 至少需要六类组件:
- Automation:定时、事件或人工触发,并明确去重和并发策略。
- Worktree/Workspace:隔离并行任务的文件和状态,避免互相覆盖。
- Skills:沉淀项目规范、流程、验收命令和已知陷阱,保持可版本化。
- Plugins/Connectors:连接浏览器、代码仓库、CI 或业务系统,并使用最小权限。
- Sub-agents:把执行、检查和复核拆开,减少单一智能体的自审盲区。
- Memory:持久化目标、计划、已完成步骤、错误证据和下一次恢复点。
建议显式建模状态,并给每次运行设置步数、时间和成本上限:
received -> planning -> ready -> running -> verifying
                              |             |
                              |             +-> completed
                              +-> retryable-failure -> ready
                              +-> approval-needed -> paused
                              +-> fatal-failure -> failed
重试只能针对分类明确且具备幂等保护的失败;写操作重复执行前要查询幂等记录。恢复时先校验任务所有者、状态版本和外部副作用,不能因为缓存中没有上下文就重新执行整个任务。
5. 从四层到发布门禁
一次可审计的交付可以按以下顺序组织:
目标与验收 -> Prompt 模板 -> Context 组装与权限过滤
           -> Harness 执行与轨迹 -> Verification 评测
           -> Loop 决策:完成 / 修正 / 重试 / 人工接管 / 停止
发布前至少验证正常、歧义、越权、提示注入、工具超时、上下文缺失和取消恢复;每条失败路径都要有用户可理解的状态和回滚点。评测结果、工具轨迹和人工接管原因应与版本绑定,便于判断是模型、上下文还是工程约束发生了变化。
6. 面试追问
- Prompt、Context 和 Harness 的边界如何划分?为什么不能只靠 Prompt 防止越权?
- ETCLOVG 中哪个层负责“任务完成”的判定?它和模型自评有什么区别?
- Loop 如何避免无限重试?哪些失败可以自动重试,哪些必须人工接管?
- 多 Agent 并行修改同一仓库时,Worktree、Memory 和 Verification 如何配合?